


W kawiarni
Bez Clarity
Gwar zajmuje wykrywanie końca wypowiedzi: Twój agent czeka albo przerywa.
Z Clarity
Twój agent odpowiada, gdy rozmówca skończy mówić.
Clarity usuwa szumy tła w czasie rzeczywistym, a z krótką próbką głosu także każdy głos poza głosem rozmówcy.
Włącz odtwarzanie, potem włącz Clarity.
Każda próbka: dzwoniąca osoba, cichszy drugi głos i hałas miejsca.
Bez Clarity
Gwar zajmuje wykrywanie końca wypowiedzi: Twój agent czeka albo przerywa.
Z Clarity
Twój agent odpowiada, gdy rozmówca skończy mówić.
Bez Clarity
Głosy tłumu trafiają do transkrypcji.
Z Clarity
Transkrypcja zawiera to, co powiedział rozmówca.
Bez Clarity
„Tak” kolegi liczy się jako odpowiedź rozmówcy.
Z Clarity
Z próbką głosu od 2 do 8 sekund Twój agent słyszy tylko rozmówcę.
W obu publicznych benchmarkach Clarity 1 daje Twojemu agentowi najczystszy dźwięk spośród modeli strumieniowych w teście.
Libri2Mix · DNSMOS, wyżej znaczy lepiej
| Metryka | Clarity 1240 ms | StarTSE[1]560 ms |
|---|---|---|
| Jakość mowy SIG | 3.56 (najlepszy) | 3.54 |
| Jakość tła BAK | 4.03 (najlepszy) | 3.75 |
| Jakość ogólna OVRL | 3.27 (najlepszy) | 3.12 |
DNS 2020 Challenge · DNSMOS, wyżej znaczy lepiej
| Metryka | Clarity 1240 ms | Bez przetwarzaniaOryginalne nagranie | AI Acoustics15 ms | DeepFilterNet310 ms | GTCRN16 ms |
|---|---|---|---|---|---|
| Jakość mowy SIG | 3.62 (najlepszy) | 3.39 | 3.46 | 3.51 | 3.34 |
| Jakość tła BAK | 4.11 (najlepszy) | 2.62 | 3.60 | 4.11 (najlepszy) | 3.98 |
| Jakość ogólna OVRL | 3.37 (najlepszy) | 2.48 | 2.98 | 3.25 | 3.05 |
DeepFilterNet3 remisuje w jakości tła bez pogłosu; modele offline, które potrzebują całego nagrania, uzyskują do 0,08 więcej przy wyodrębnianiu mówcy.
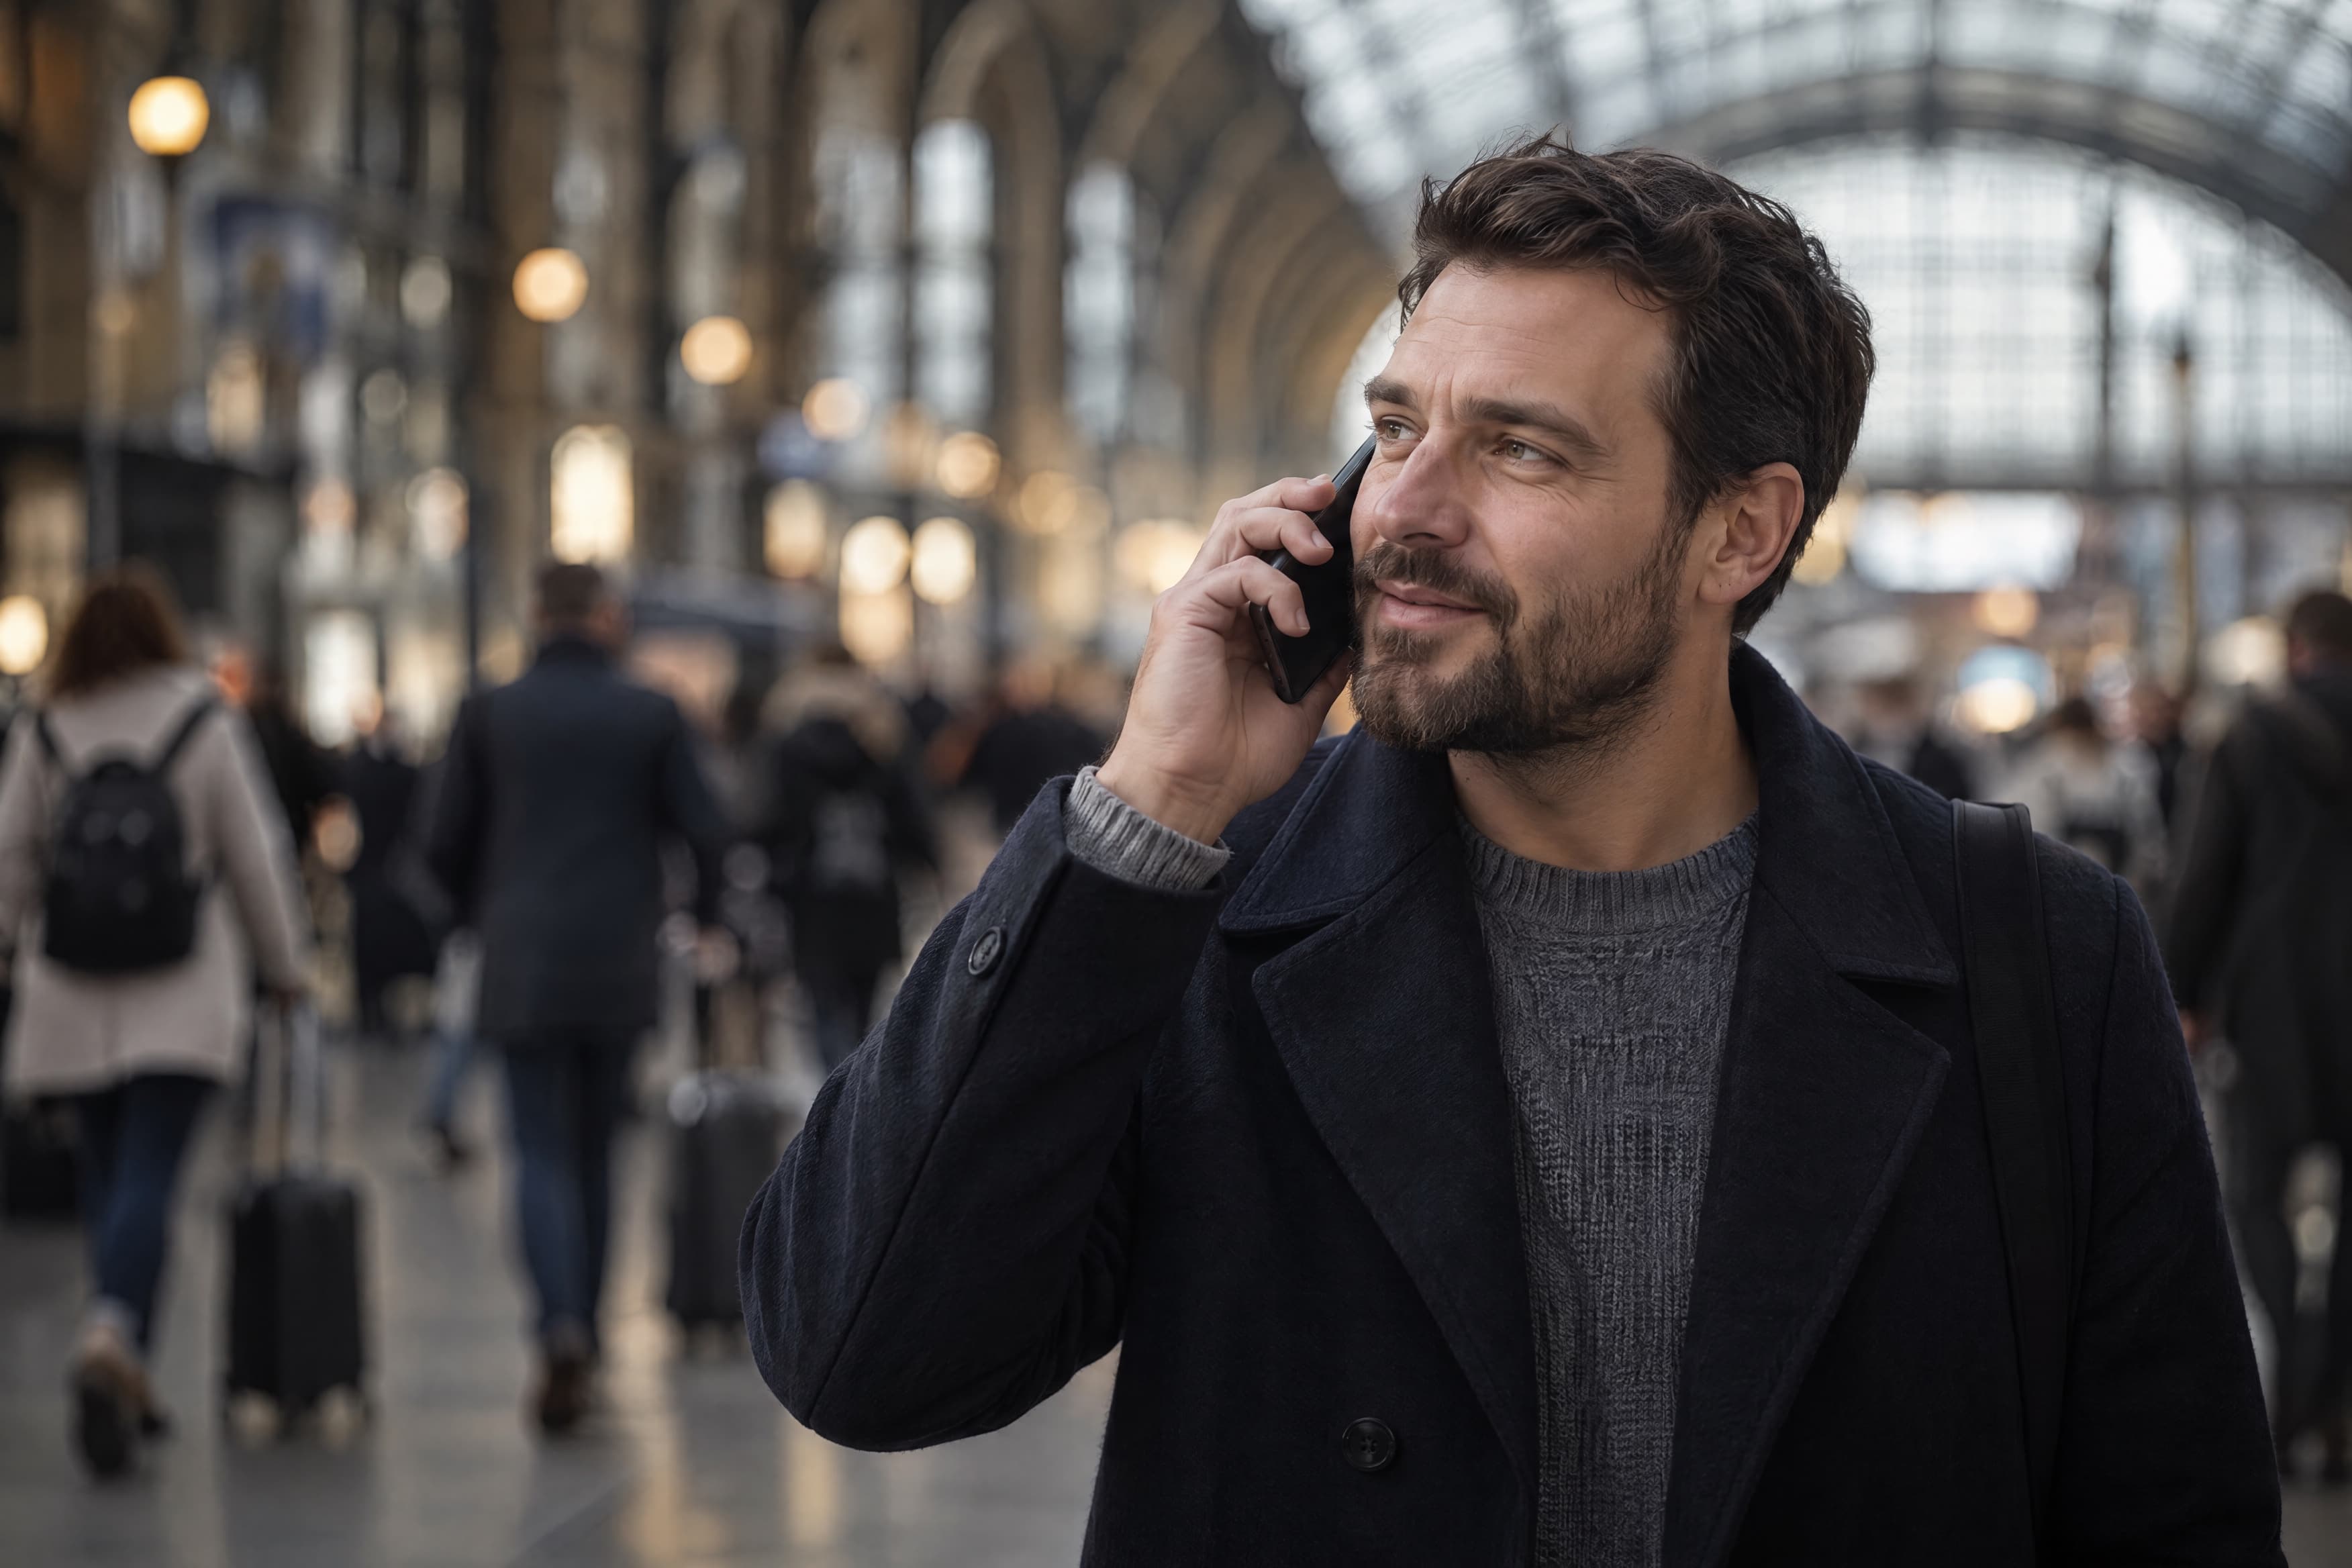
Twój agent słyszy tylko rozmówcę, nawet w hali dworca.
Klienci słyszą Twoją konsultantkę, bez hałasu, echa i kolegów dookoła.
Clarity działa strumieniowo na wejściu audio Twojego agenta, więc wszystko dalej pracuje na oczyszczonym głosie rozmówcy.
from livekit.agents import room_io
from kugelaudio import load_audio
from kugelaudio.livekit import enhancement

await session.start(
    room=ctx.room,
    agent=agent,
    room_options=room_io.RoomOptions(
        audio_input=room_io.AudioInputOptions(
            noise_cancellation=enhancement(),  # reads KUGELAUDIO_API_KEY
            # keep one voice: enhancement(speaker=load_audio("caller.wav"))
        ),
    ),
)Pierwszy model Clarity, do nagrań i dźwięku na żywo.
clarity-1POST /v1/audio/enhanceWS /v1/audio/enhance/stream0,0015 €za minutę dźwięku, bez VAT
Rozliczane z Twoich kredytów za każdą sekundę dźwięku wejściowego, z zaokrągleniem w górę, minimum jedna sekunda. Żądania zakończone błędem nie są rozliczane.
ZacznijSelf-hosting i wdrożenie on-premise, w planach Enterprise.
Linia modeli KugelAudio do poprawy mowy. Clarity 1 (clarity-1) usuwa szumy tła, a z próbką głosu zachowuje tylko ten głos, w nagraniach i dźwięku na żywo.
Około 50 ms, jeśli Twój pipeline i tak czyta dźwięk we fragmentach po 240 ms. Przy mniejszych ramkach dźwięk może wyjść do 290 ms po wejściu.
Po próbce tej osoby o długości od 2 do 8 sekund, najlepiej samej i z małym szumem. Bez próbki Clarity usuwa szumy i zachowuje mowę.
WAV od 8 do 48 kHz, do 300 sekund na nagranie, albo 16-bitowy PCM na żywo przez WebSocket. Wyjście to PCM mono 16 bitów, 24 kHz.
Tak. Self-hosting i wdrożenie on-premise są dostępne w planach Enterprise.