


En una cafetería
Sin Clarity
Las conversaciones ocupan la detección de turnos: tu agente espera o interrumpe.
Con Clarity
Tu agente responde cuando quien llama deja de hablar.
Clarity elimina el ruido de fondo en tiempo real y, con una muestra corta de voz, todas las voces menos la de quien llama.
Pulsa reproducir y luego activa Clarity.
Cada muestra: una persona que llama, una segunda voz más baja y el ruido del lugar.
Sin Clarity
Las conversaciones ocupan la detección de turnos: tu agente espera o interrumpe.
Con Clarity
Tu agente responde cuando quien llama deja de hablar.
Sin Clarity
Las voces de la multitud acaban en la transcripción.
Con Clarity
La transcripción recoge lo que dijo quien llama.
Sin Clarity
El «sí» de un compañero cuenta como respuesta de quien llama.
Con Clarity
Con una muestra de voz de 2 a 8 segundos, tu agente solo oye a quien llama.
En los dos benchmarks públicos, Clarity 1 da a tu agente el audio más limpio de todos los modelos de streaming de la prueba.
Libri2Mix · DNSMOS, más alto es mejor
| Métrica | Clarity 1240 ms | StarTSE[1]560 ms |
|---|---|---|
| Calidad de la voz SIG | 3.56 (mejor) | 3.54 |
| Calidad del fondo BAK | 4.03 (mejor) | 3.75 |
| Calidad global OVRL | 3.27 (mejor) | 3.12 |
DNS 2020 Challenge · DNSMOS, más alto es mejor
| Métrica | Clarity 1240 ms | Sin procesarAudio original | AI Acoustics15 ms | DeepFilterNet310 ms | GTCRN16 ms |
|---|---|---|---|---|---|
| Calidad de la voz SIG | 3.62 (mejor) | 3.39 | 3.46 | 3.51 | 3.34 |
| Calidad del fondo BAK | 4.11 (mejor) | 2.62 | 3.60 | 4.11 (mejor) | 3.98 |
| Calidad global OVRL | 3.37 (mejor) | 2.48 | 2.98 | 3.25 | 3.05 |
DeepFilterNet3 empata en calidad del fondo sin reverberación; los modelos offline, que necesitan la grabación completa, puntúan hasta 0,08 más en la extracción del hablante.
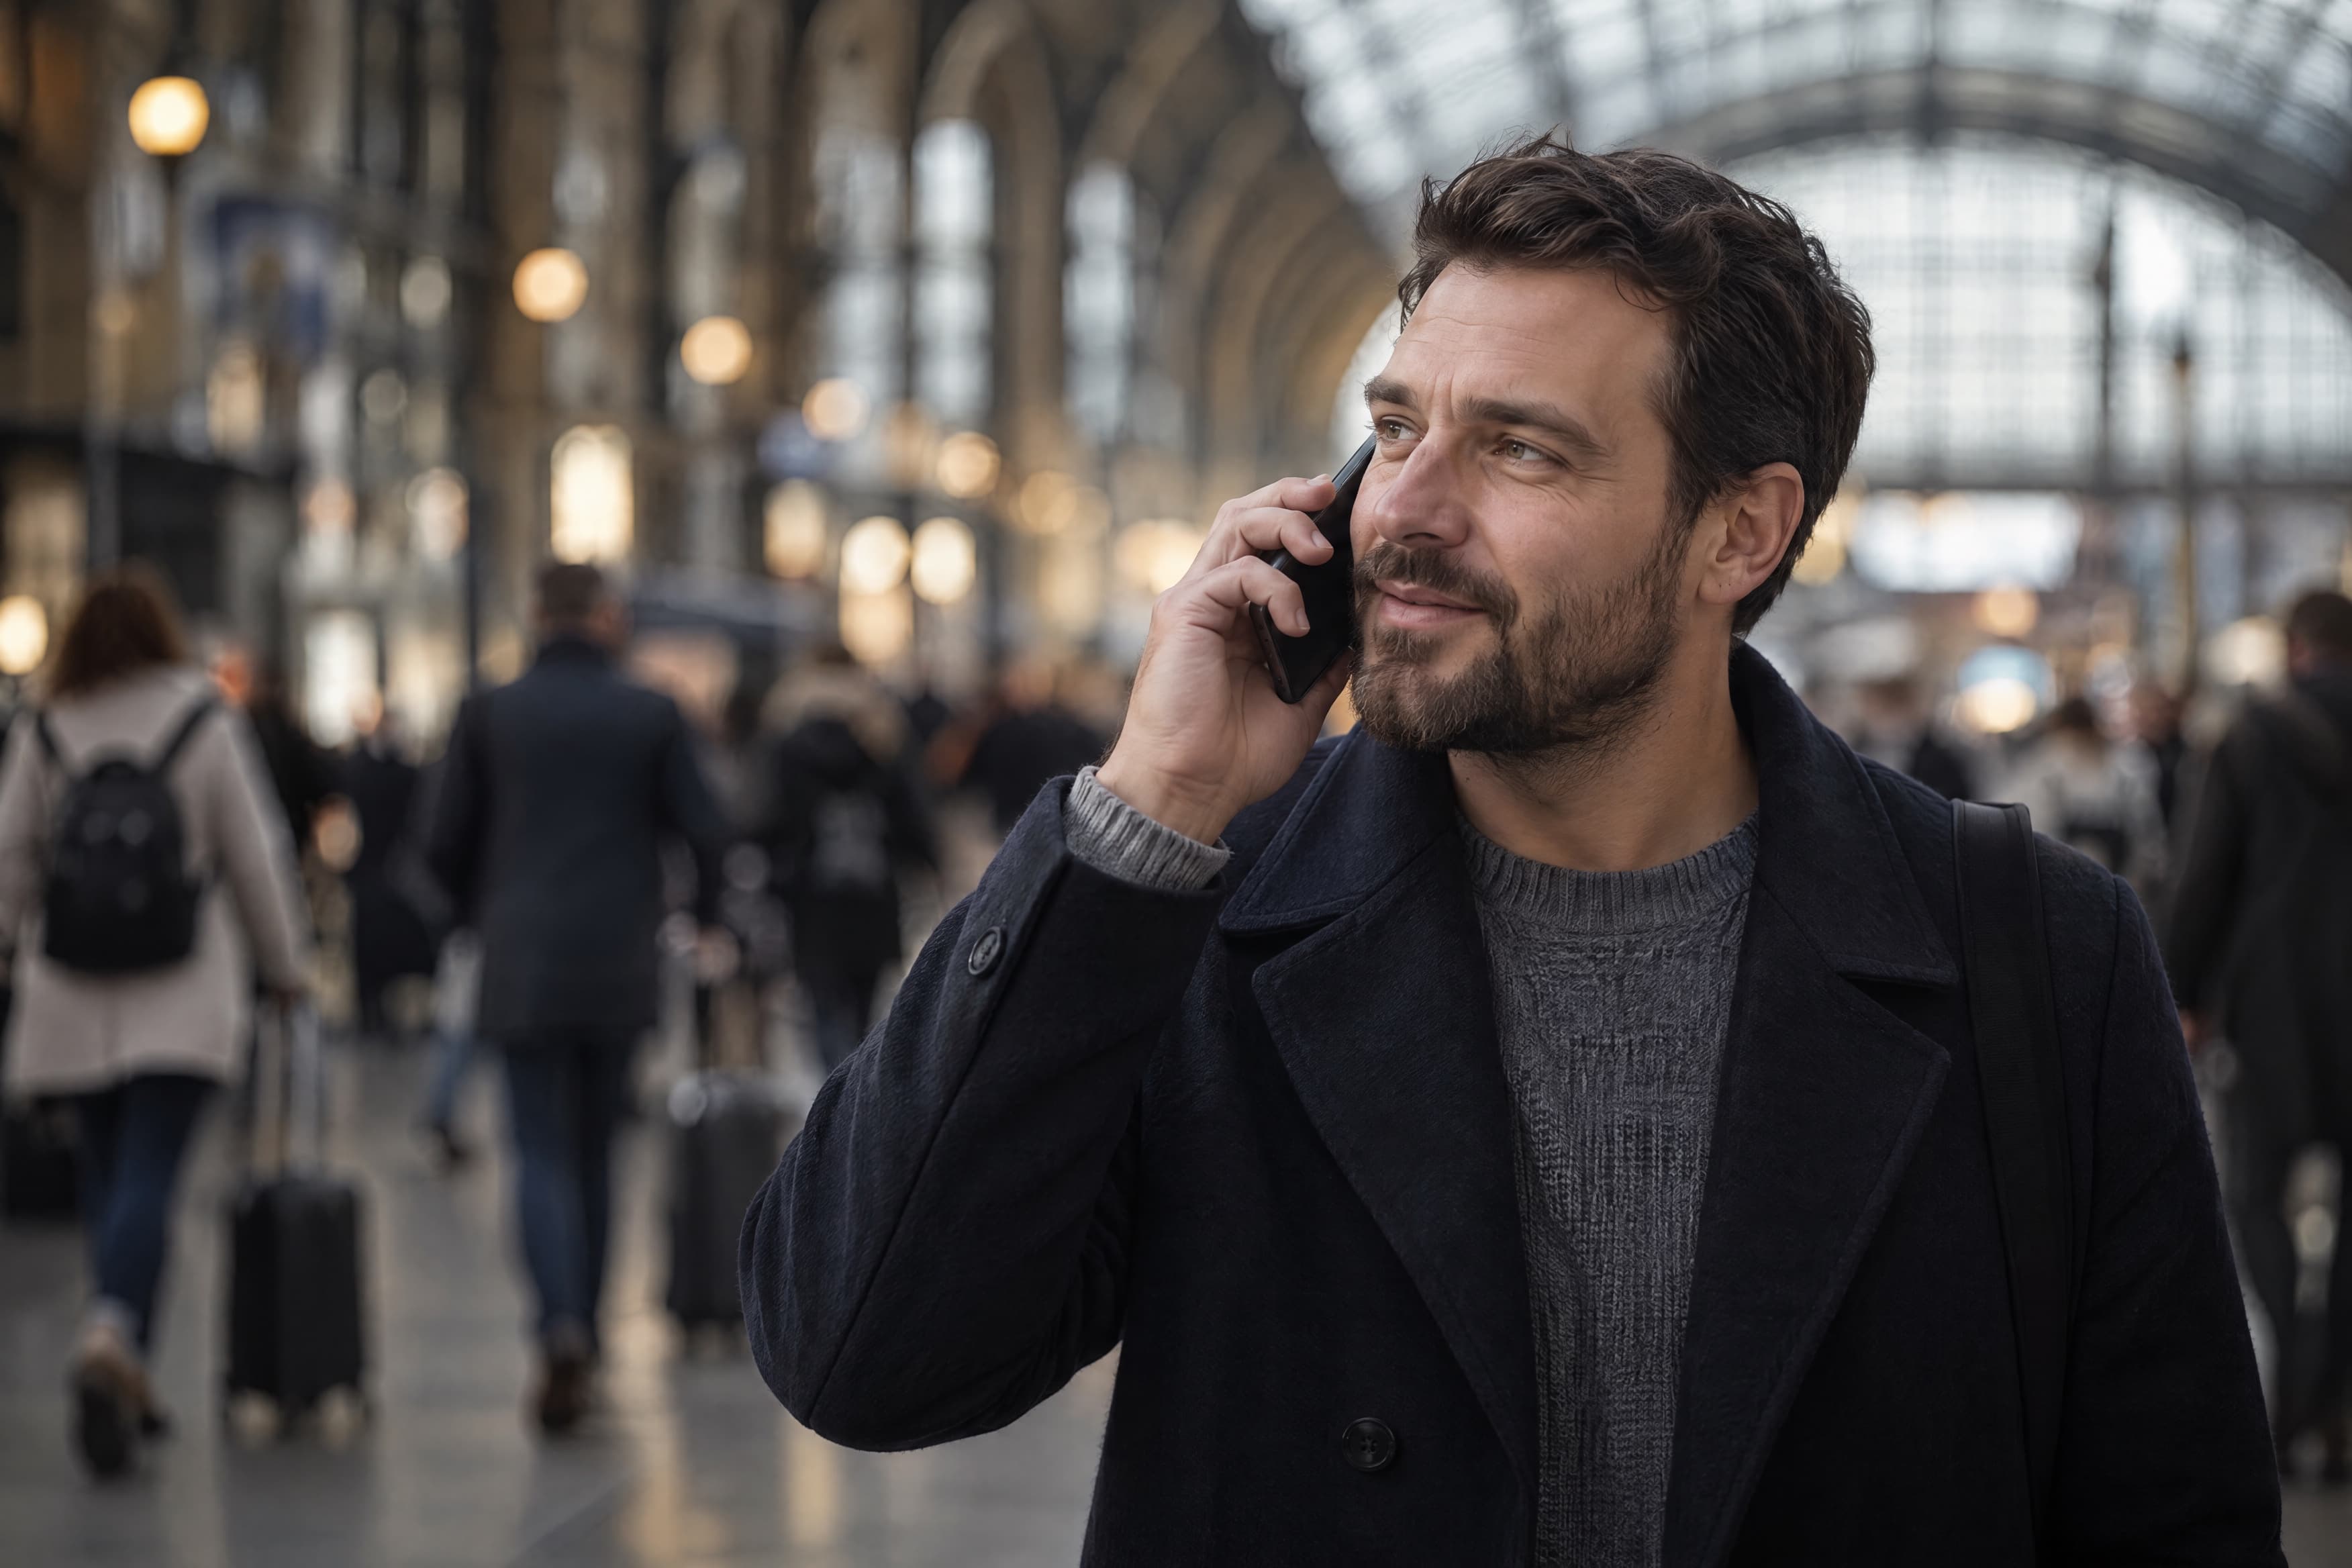
Tu agente solo oye a quien llama, incluso en el vestíbulo de una estación.
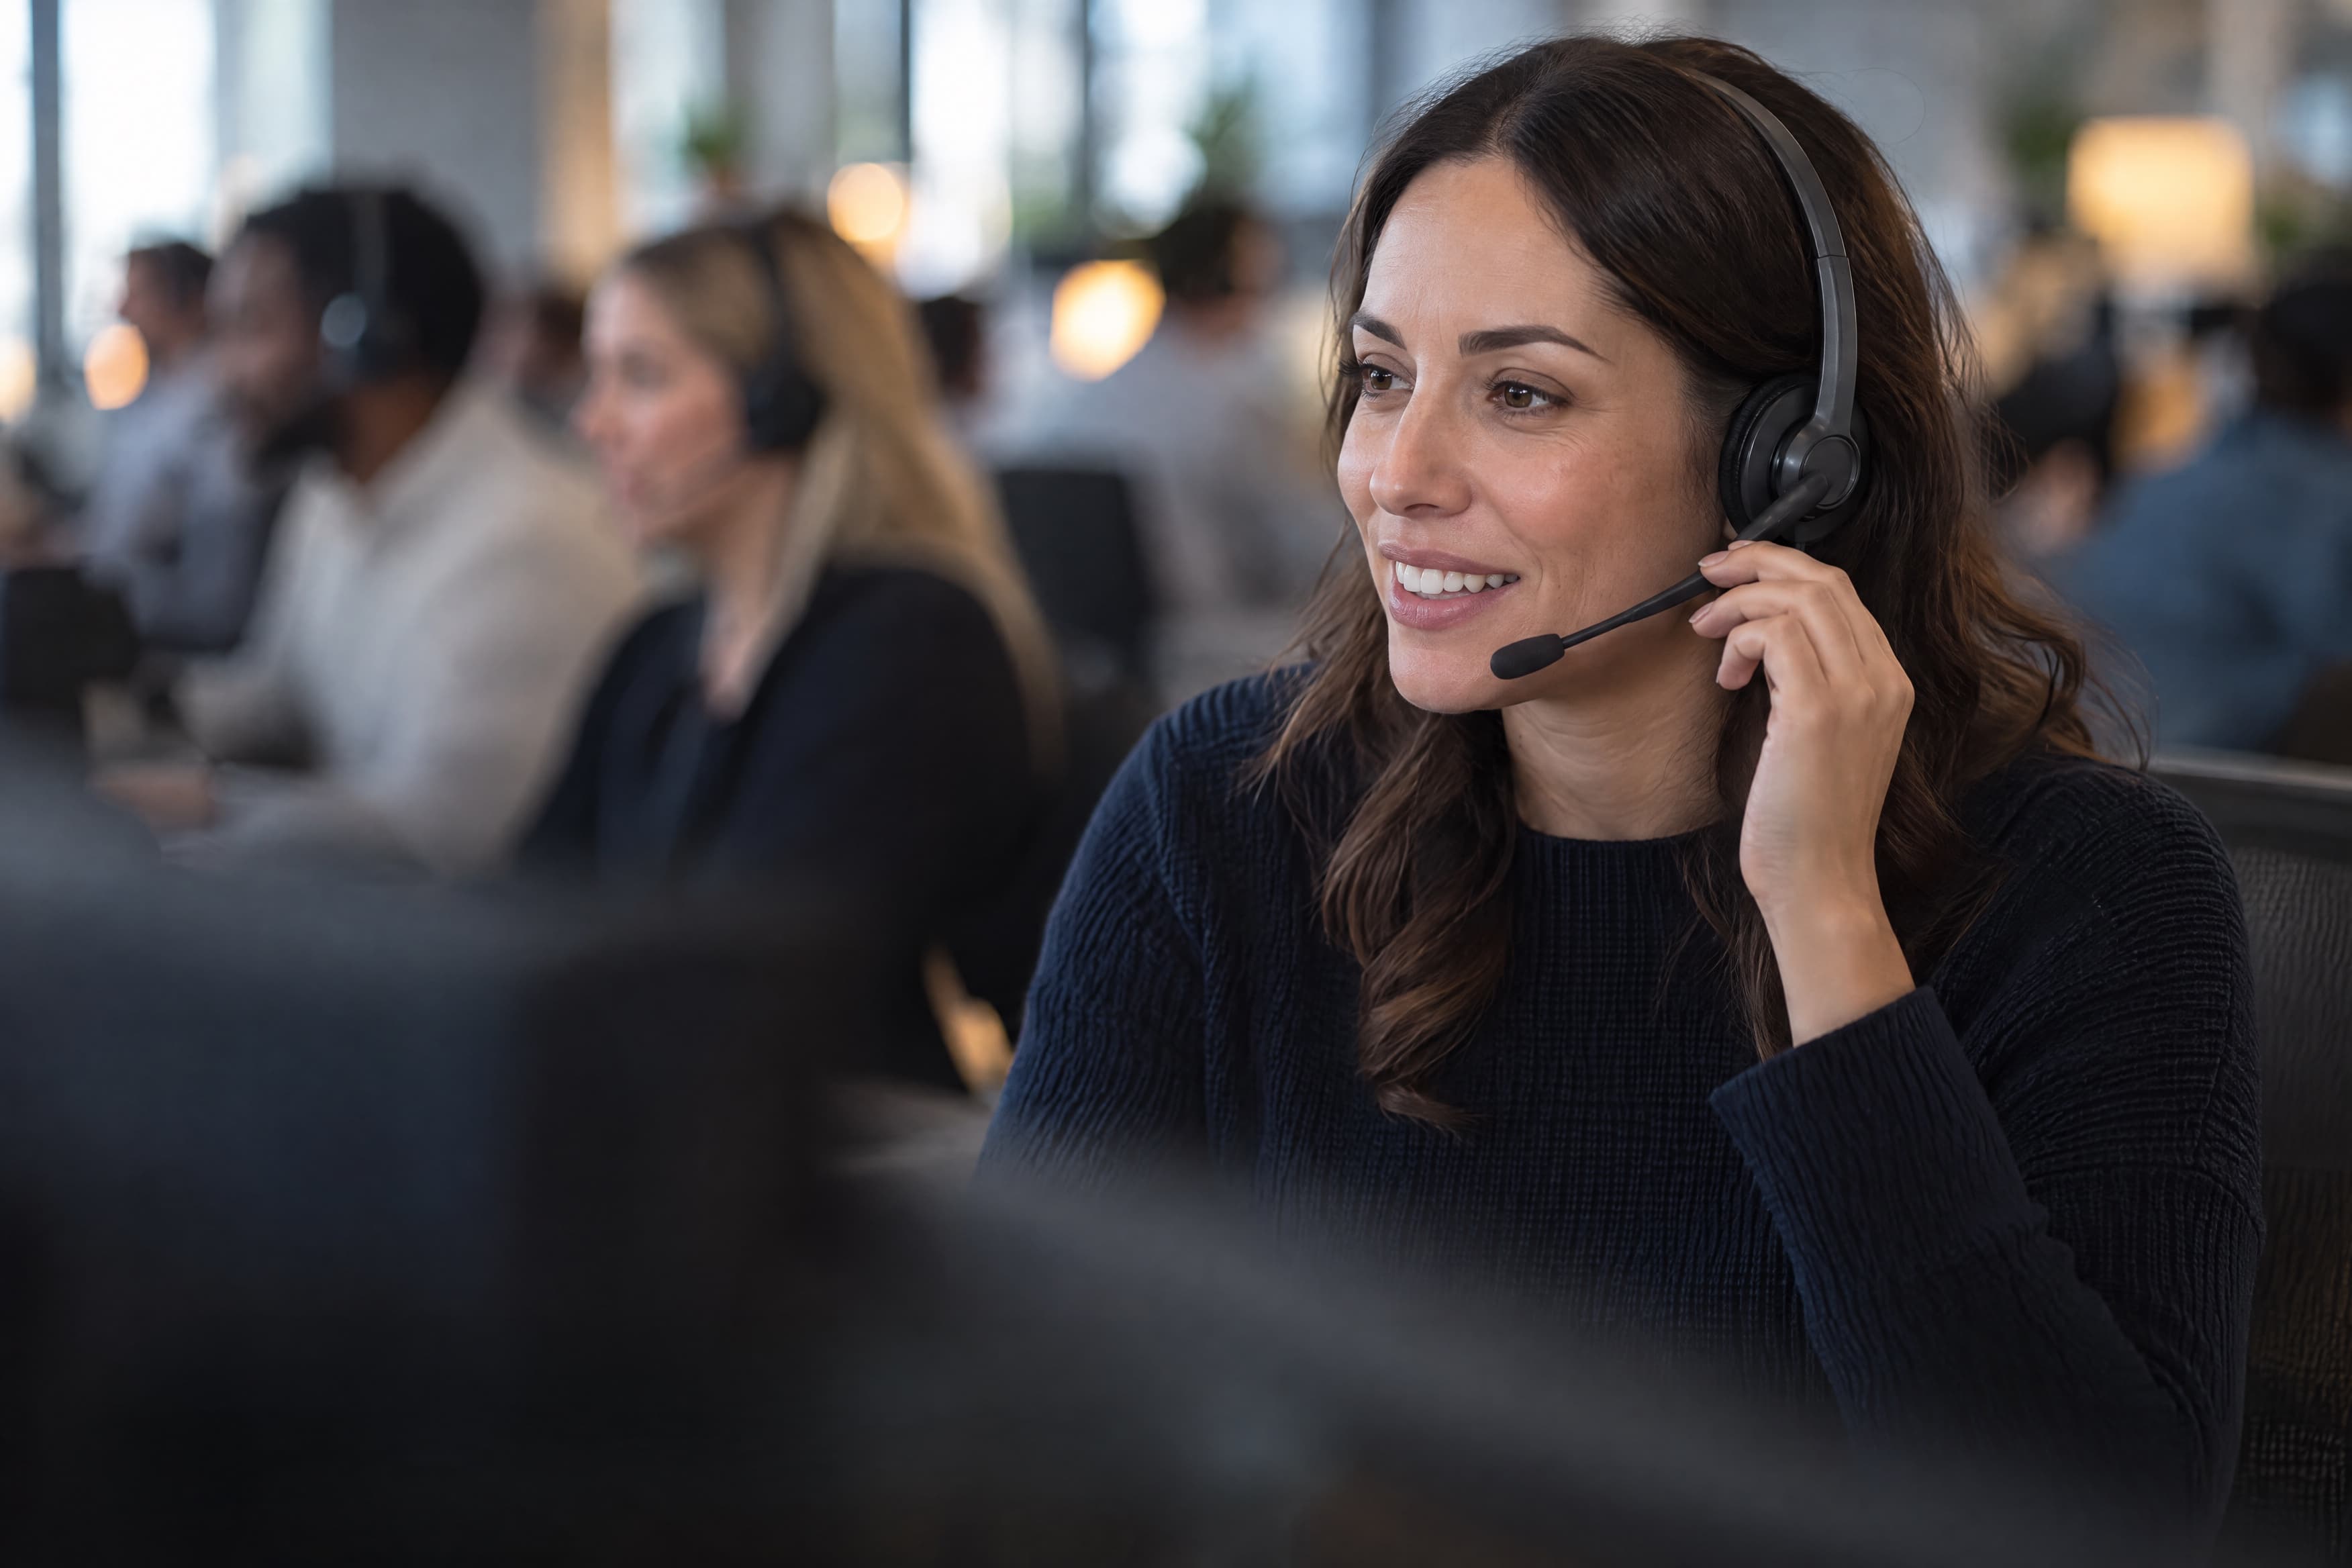
Tus clientes oyen a tu agente, sin el ruido, el eco ni los compañeros de alrededor.
Clarity va en la entrada de audio de tu agente y funciona en streaming, así que todo lo que viene después trabaja con la voz limpia de quien llama.
from livekit.agents import room_io
from kugelaudio import load_audio
from kugelaudio.livekit import enhancement

await session.start(
    room=ctx.room,
    agent=agent,
    room_options=room_io.RoomOptions(
        audio_input=room_io.AudioInputOptions(
            noise_cancellation=enhancement(),  # reads KUGELAUDIO_API_KEY
            # keep one voice: enhancement(speaker=load_audio("caller.wav"))
        ),
    ),
)El primer modelo Clarity, para grabaciones y audio en directo.
clarity-1POST /v1/audio/enhanceWS /v1/audio/enhance/stream0,0015 €por minuto de audio, IVA no incluido
Se factura de tus créditos por segundo de audio de entrada, redondeado hacia arriba, con un mínimo de un segundo. Las solicitudes con error no se facturan.
ComenzarAutoalojamiento y despliegue on-premise, con los planes Enterprise.
La línea de modelos de mejora de voz de KugelAudio. Clarity 1 (clarity-1) elimina el ruido de fondo y, con una muestra de voz, conserva solo esa voz, en grabaciones y audio en directo.
Unos 50 ms si tu pipeline ya lee el audio en fragmentos de 240 ms. Con tramas más pequeñas, un sonido puede salir hasta 290 ms después de entrar.
Por una muestra de 2 a 8 segundos de esa persona, mejor sola y con poco ruido. Sin muestra, Clarity elimina el ruido y conserva la voz.
WAV de 8 a 48 kHz, hasta 300 segundos por grabación, o PCM de 16 bits en directo por WebSocket. La salida es PCM mono de 16 bits a 24 kHz.
Sí. El autoalojamiento y el despliegue on-premise están disponibles con los planes Enterprise.